一、前言:為什麼不適合直接用線性迴歸進行分類?
線性迴歸的設計目標是預測連續型的數值(例如房價、溫度),若將其用於分類任務(例如預測是/否,以大於 0.5 算 1,小於 0.5 算 0),會遇到以下四個問題:
1. 輸出範圍無邊界
線性迴歸的預測公式為 ,其輸出範圍涵蓋整個實數空間 。 在分類任務中,模型輸出的機率必須限制在 之間。若預測出 或 ,在數學與業務邏輯上較難給予合理解釋。
2. 易受異常值(Outliers)影響
線性迴歸使用最小平方法,會嘗試擬合所有的數據點。 若數據中存在特徵值極大的正樣本,整條擬合直線會產生偏移,導致決策邊界( 的位置)變動,可能使得原本能正確分類的樣本被誤判。
3. 對高置信度預測的高懲罰
假設某個樣本的真實標籤為 (正類):
- 若模型預測 ,誤差為 。
- 若模型預測 (代表模型給予極高的預測值),在使用均方誤差(MSE)時,誤差會被計算為 。 模型對於方向正確但數值較大的預測給予懲罰,在分類邏輯上並不合理。
4. 階躍函數不可導
若使用階躍函數(例如 ;)將線性輸出截斷為 0 和 1,會得到一個非連續的函數。此函數在分界點不可導,在其他地方導數均為 0,導致梯度下降法無法運作,模型難以訓練。
小結:分類任務為何需要預測「機率」?
預測連續的機率值( 到 之間)相較於直接輸出硬分類結果有以下優勢:
- 量化不確定性:模型預測「有 的機率為垃圾郵件」比「這是垃圾郵件」提供更多資訊。
- 靈活的決策閾值(Threshold):輸出為機率,便能根據應用場景調整判斷標準(例如在醫療篩檢中調低閾值以防漏診)。
- 計算損失較精準:機率值能反映模型預測的偏差程度,有助於損失函數微調權重。
二、邏輯迴歸的基礎:引入 Sigmoid 函數
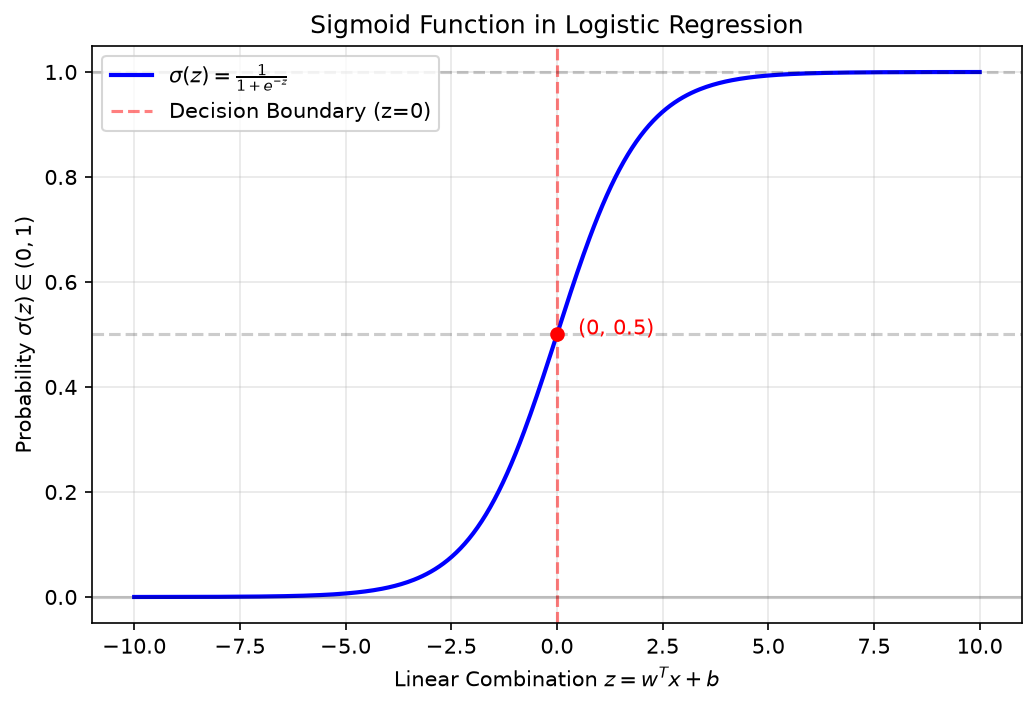
為解決線性迴歸無邊界的問題,我們引入非線性函數(Sigmoid 函數),將輸出限制在 之間,這便是邏輯迴歸的基礎。 即:線性迴歸計算數值,Sigmoid 轉換為機率。
1. Sigmoid 函數公式與圖形
將線性迴歸結果 套入公式:
2. Sigmoid 函數的特性
Sigmoid 符合分類任務的需求:
- 輸出具備機率含義:數值限制在 之間,0.8 代表模型評估為正類的機率為 80%。
- 具備決策分界點:。 判為正類, 判為負類,決策邊界即為 。
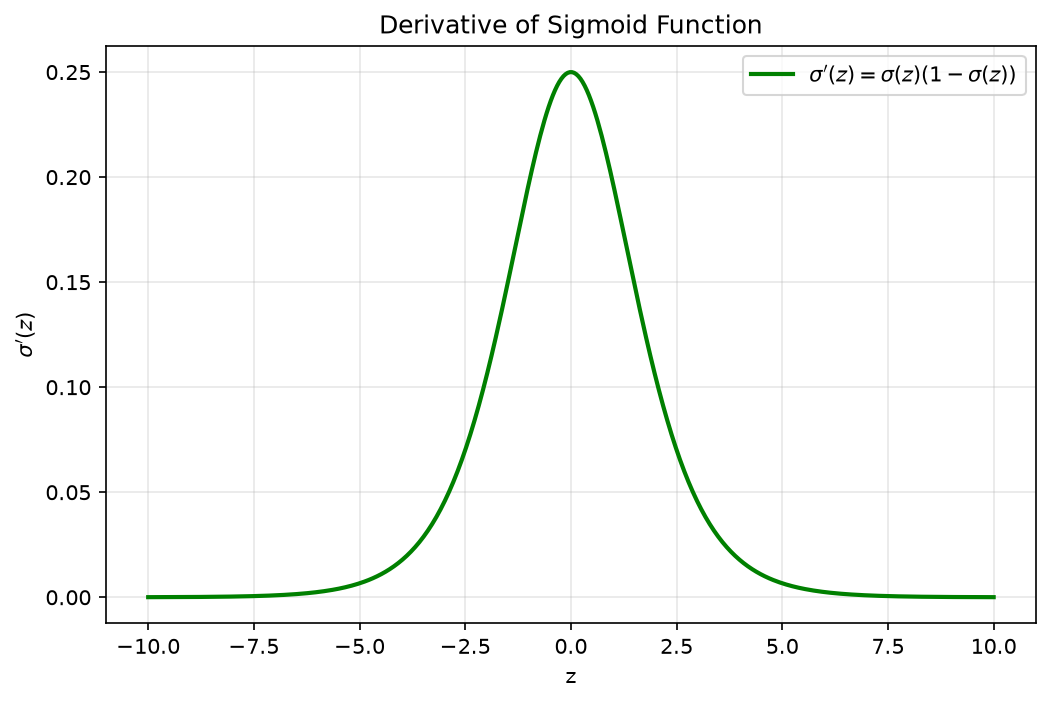
- 處處可導:,便於使用梯度下降法。
3. 數學推導與運算效率
A. 為什麼 ?
根據微積分的鏈式法則,推導如下: 將分子拆解並重新整理:
B. 對運算效率的幫助
在前向傳播時已計算出 。在反向傳播求梯度時,只需利用前向傳播的結果進行乘法運算 ,無需重新計算指數函數 ,從而節省運算資源。
三、模型訓練:均方誤差 (MSE) 的侷限性
若直接將 MSE 應用於邏輯迴歸的機率輸出,會產生以下問題。
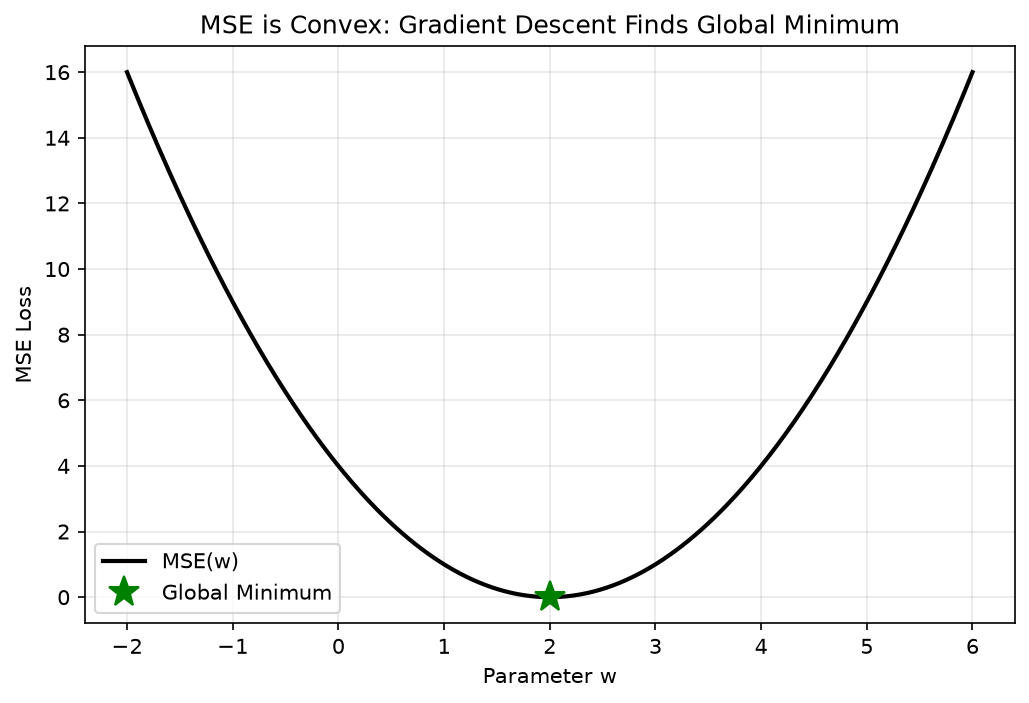
1. 線性迴歸 + MSE:凸函數
線性迴歸搭配 MSE 會形成一個凸函數 (Convex Function),保證梯度下降能找到全局最優解。
2. 邏輯迴歸 + MSE:非凸函數
由於 Sigmoid 函數的非線性,若在此使用 MSE,損失函數會變成非凸函數(Non-convex Function),帶來兩個問題:
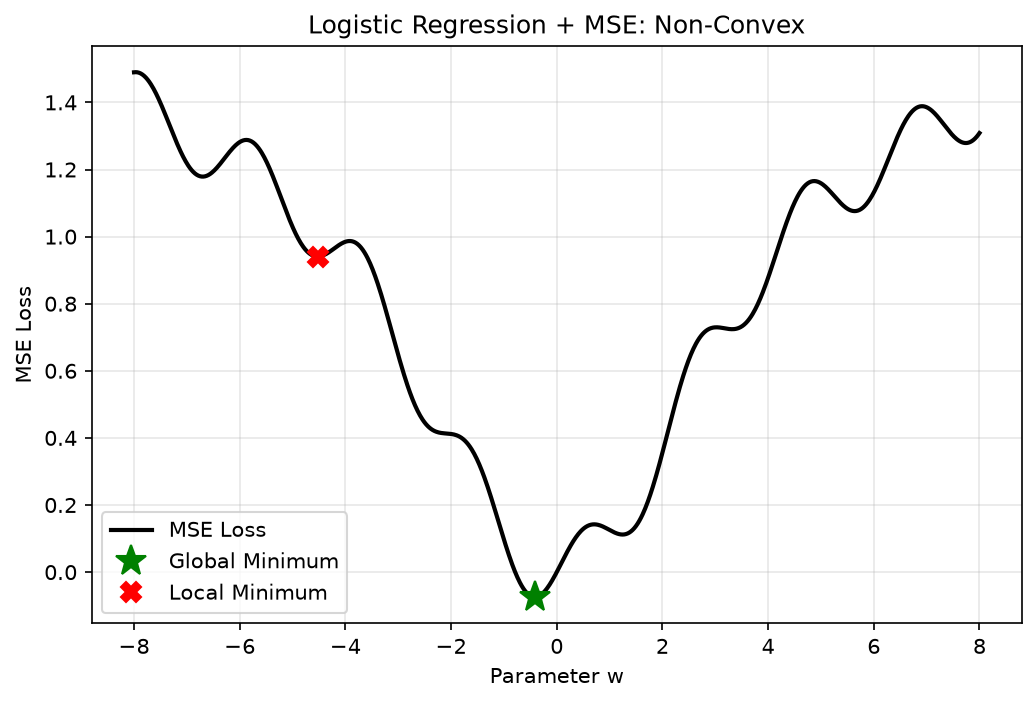
局部最優(Local Minimum)
梯度下降法可能在非凸函數的局部凹陷處停止更新,使得模型陷入局部最優解,無法抵達真正的最低點(全局最優解)。
梯度消失(Gradient Vanishing)
當模型初期的預測誤差極大(例如真實 ,預測 )時,Sigmoid 的導數 會趨近於 0(飽和區)。 此時雖然預測偏差大,但因為梯度趨於 0,參數的更新步長極小,模型學習速度會變得非常緩慢。
四、設計分類損失函數
為避免 MSE 應用於分類時的問題,針對分類問題的損失函數通常需具備以下特徵: 假設模型輸出機率為 :
- 當真實標籤 , 越接近 1 損失越小, 越接近 0 損失則越大。
- 當真實標籤 , 越接近 0 損失越小, 越接近 1 損失則越大。
[!NOTE] 損失最大的情況通常是模型對錯誤的分類給予極高的置信度(例如真實 ,卻給出 )。
五、推導交叉熵損失(Cross-Entropy Loss)
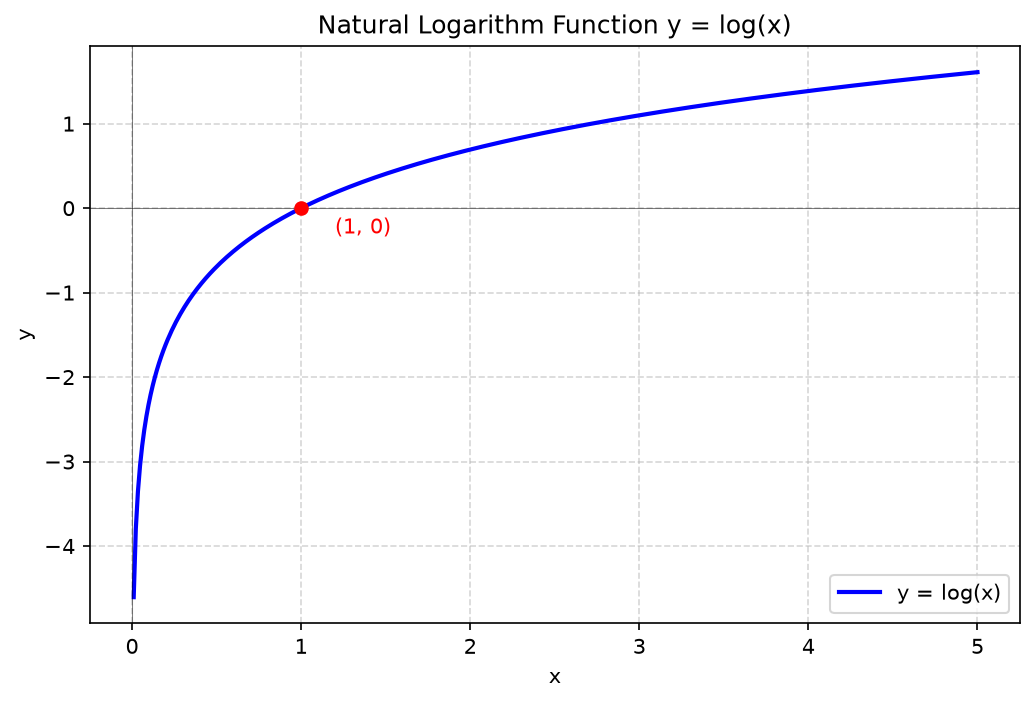
工具一:對數函數(Logarithm)
在推導損失函數時,對數()具有多方面的實用性:
1. 數學視角:單調性
- 對數函數 是一個嚴格單調遞增的函數。
- 我們可以將「最大化機率」等價替換成「最大化機率的對數」。極值發生的位置不變,但乘法可轉換為加法,簡化運算。
2. 工程視角:防止數值下溢出
- 聯合機率需將所有單一事件的機率相乘。多個小於 的數值連乘,會迅速趨近於 ,超出電腦浮點數能表示的下限,發生數值下溢出(Underflow),導致梯度歸零。
- 引入 將連乘轉換為連加:,有效減緩數值縮小速度,避免精度問題。
3. 機器學習視角:懲罰機制
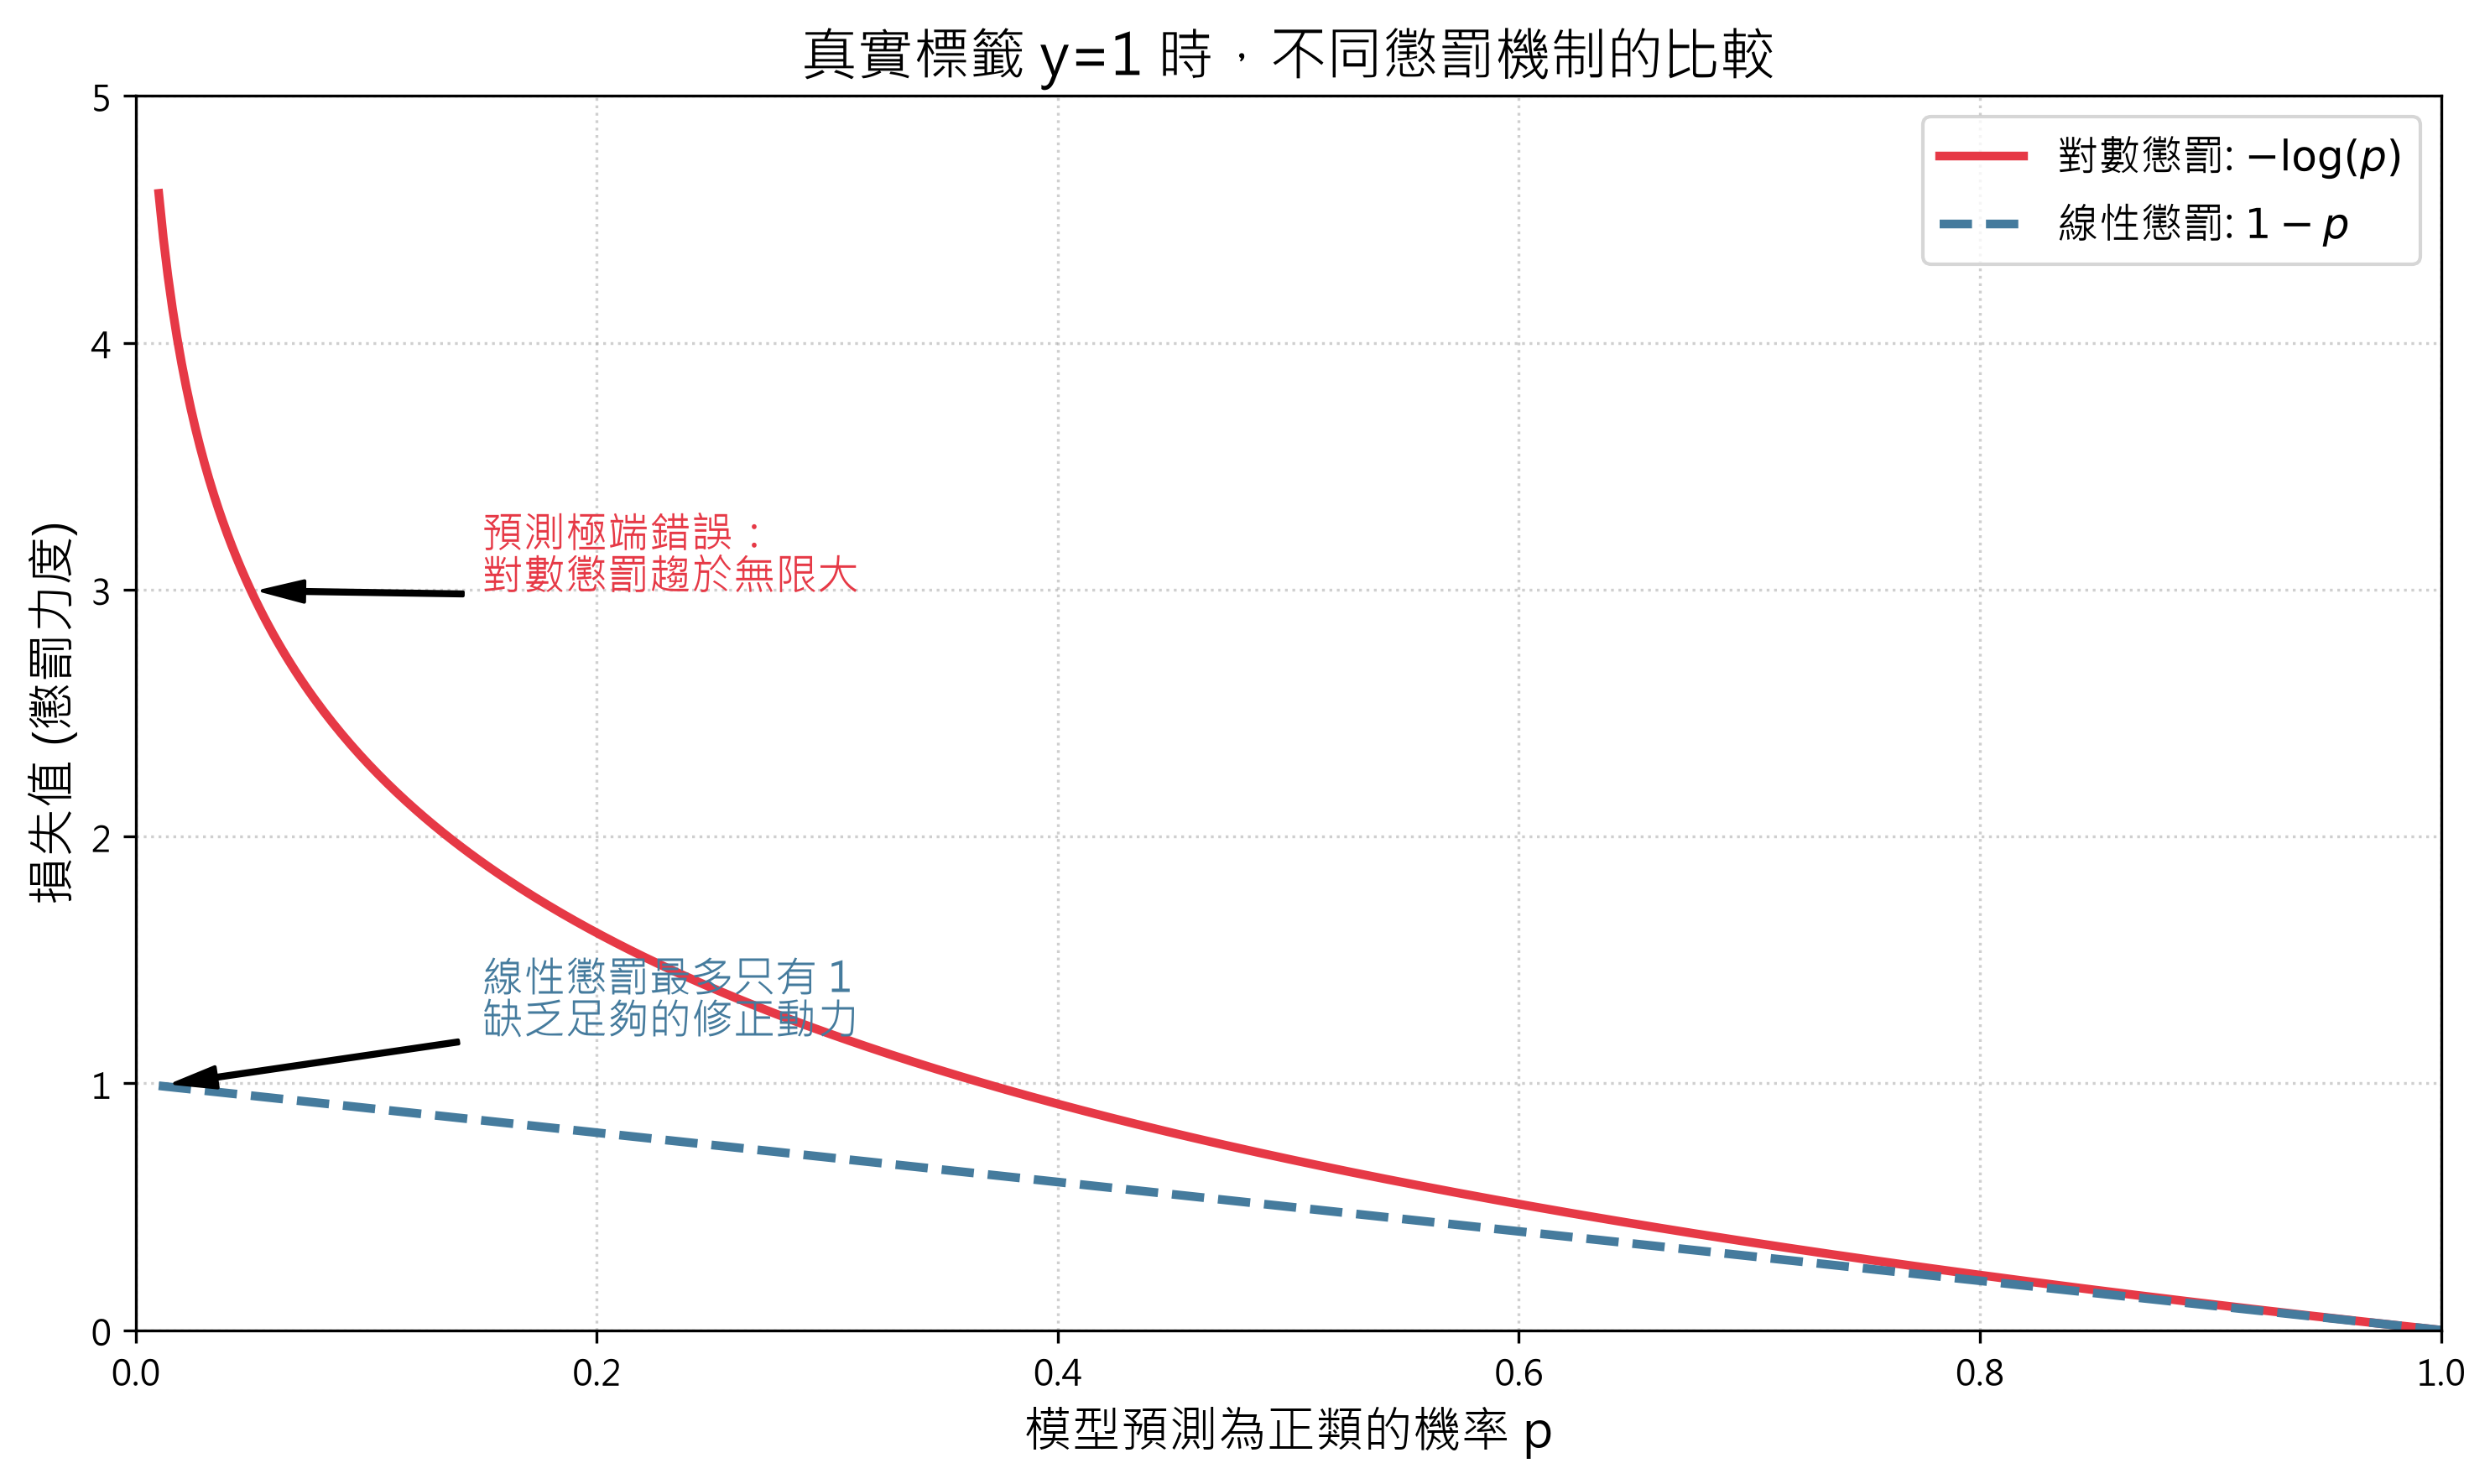
假設 是模型預測正確答案的機率:
- 當 :,損失為零。
- 當 :,損失趨近於無限大。 這種特性可確保模型在預測偏差較大時產生足夠的梯度進行修正。此外,Log 的導數 可與 Sigmoid 的導數 約分,使得梯度公式更簡潔。
工具二:伯努利分佈
在二分類問題中,假設結果為 1 的機率是 ,結果為 0 的機率是 。 可將其整合為單一機率公式:
- 當 時,公式為 。
- 當 時,公式為 。 此形式便於後續的連乘與求導操作。
工具三:最大似然估計(MLE)
最大似然估計的概念是:尋找一組參數,使得當前觀測結果發生的機率(似然函數)達到最大。
應用於邏輯迴歸
假設有 個樣本,目標是尋找最佳權重 :
- 似然函數(所有樣本預測正確的機率連乘):
- 取對數(Log-Likelihood):
結論:交叉熵損失函數
機器學習通常以「最小化損失」為目標,因此將似然函數加負號並取平均,即可得到交叉熵損失公式:
對單一樣本而言:
- 當 時,損失為
- 當 時,損失為
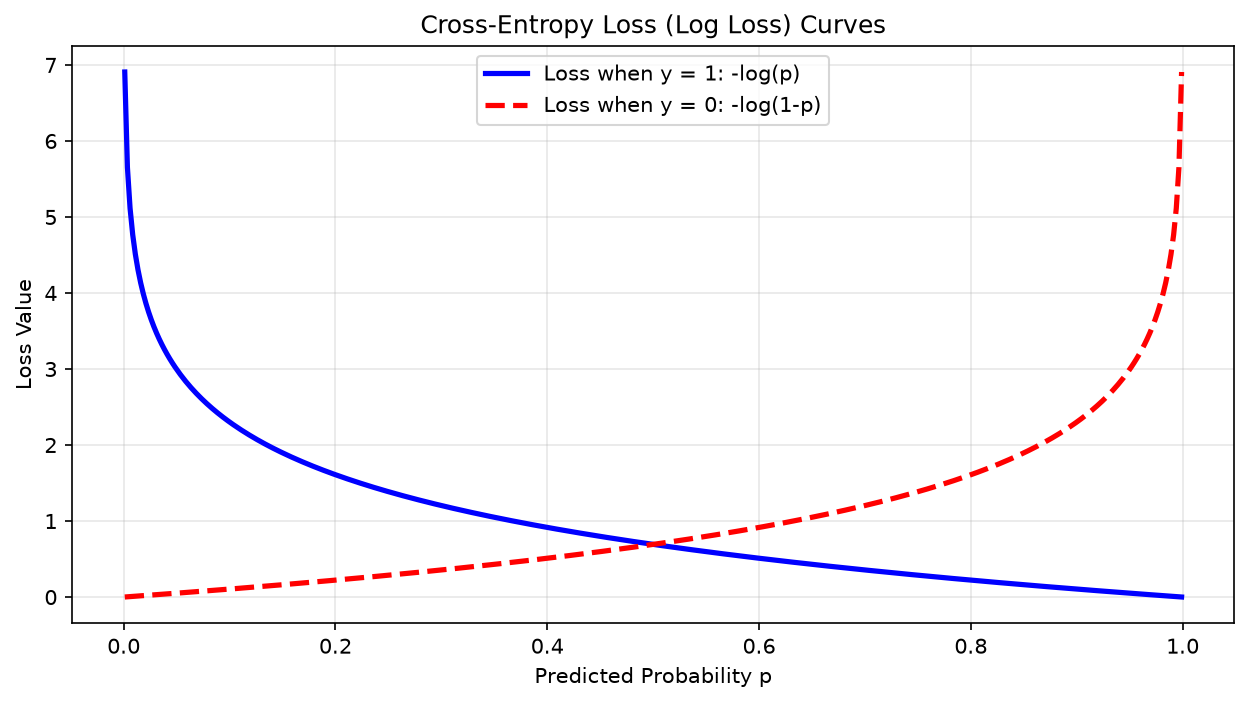
交叉熵是一個凸函數,可確保模型利用梯度下降法穩定收斂至全局最優解。
六、梯度下降:權重更新公式
利用交叉熵損失函數計算梯度後,可得到與線性迴歸形式一致的權重更新公式。
梯度公式比較
| 項目 | 線性迴歸 (Linear Regression) | 邏輯迴歸 (Logistic Regression) |
|---|---|---|
| 權重梯度 | ||
| 偏置梯度 | ||
| 的含義 | (連續數值) | (機率) |
公式特性
- 實作便利性:計算梯度的結構相同,差別僅在於 是線性輸出或經過 Sigmoid 轉換。
- 穩定性:梯度 顯示參數更新的方向與幅度,取決於預測誤差 及特徵輸入 。
七、模型評估與決策閾值
以乳癌檢測(測試集共 114 人)為例,說明如何評估模型表現。這段 Python 程式碼是使用機器學習領域最標準的工具庫 Scikit-Learn (sklearn) 來建立的。它是機器學習工程師在實作邏輯迴歸分類任務時,最經典、最標準的「工業級完整流水線(Pipeline)」,以下為完整程式碼:
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report

# 1. 載入乳腺癌數據集 (569 個樣本, 30 個特徵)
data = load_breast_cancer()
X, y = data.data, data.target

# 2. 切分訓練集 / 測試集 (比例為 8:2)
# stratify=y 確保訓練集與測試集中的正負樣本比例一致
# random_state=17 可精準重現 41 TP, 1 FN, 1 FP, 71 TN 的結果
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=17
)

# 3. 特徵縮放 (StandardScaler 標準化)
# 因為 30 個特徵的量綱(數值範圍)差異很大,標準化能幫助模型更快收斂
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. 建立與訓練邏輯迴歸模型
model = LogisticRegression(random_state=42)
model.fit(X_train_scaled, y_train)

# 5. 模型預測
y_pred = model.predict(X_test_scaled)      # 預測分類結果 (0 或 1)
y_prob = model.predict_proba(X_test_scaled) # 預測機率分布 (預測為 0 與 1 的各自機率)

# 6. 結果分析與評估
print("=== 模型評估結果 ===")
# 計算並印出準確率
accuracy = accuracy_score(y_test, y_pred)
print(f"測試集準確率: {accuracy:.4f} (即 {accuracy:.2%})")

# 計算混淆矩陣
print("\n混淆矩陣 (Confusion Matrix):")
cm = confusion_matrix(y_test, y_pred)
print(cm)

# 印出詳細的評估報告 (包含 Precision, Recall, F1-score)
print("\n分類詳細報告:")
print(classification_report(y_test, y_pred, target_names=data.target_names))
1. 預測機率分布圖
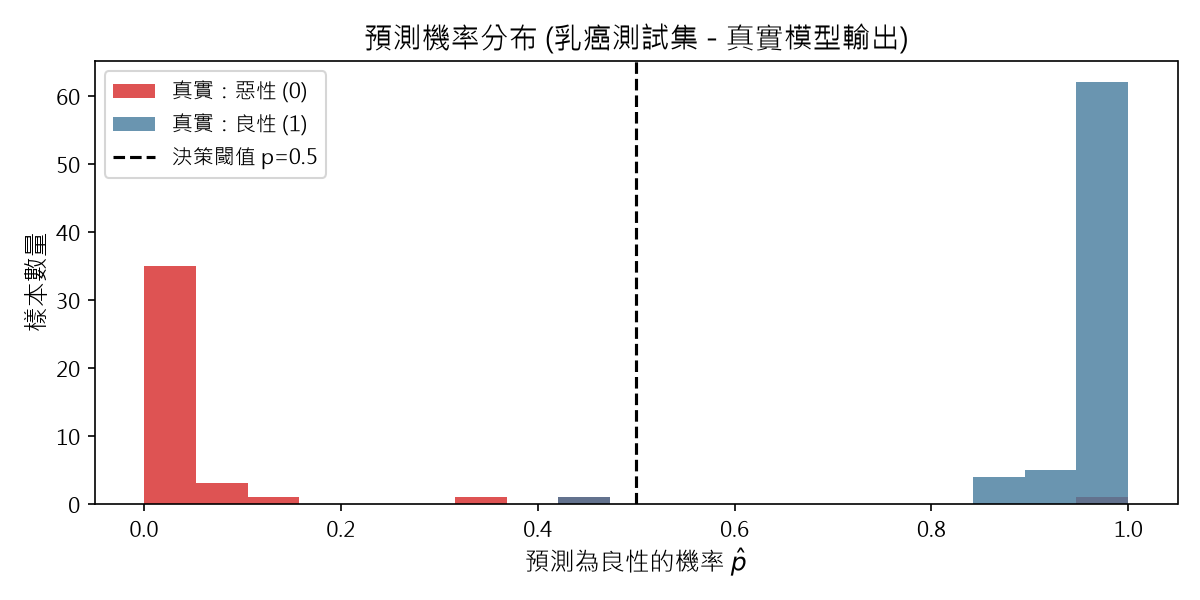
- 圖表解析:紅色區塊代表真實為惡性腫瘤的患者(集中在 0 附近),藍色區塊代表真實為良性腫瘤的患者(集中在 1 附近)。
- 結論:兩類樣本重疊度低,表示模型具備較好的區分能力。中央虛線為預設的決策閾值(Threshold = 0.5)。
2. 混淆矩陣 (Confusion Matrix)
若以 為閾值,可整理出混淆矩陣:
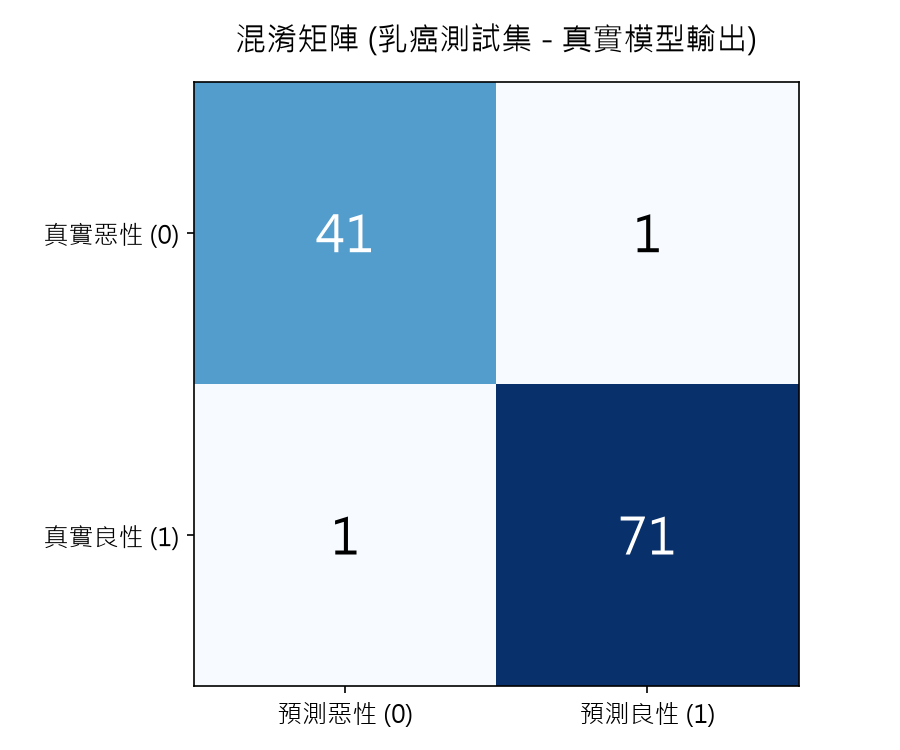
(註:在 Scikit-learn 預設資料中,惡性為 0,良性為 1。)
- 真正例 TP (左上 41):實際為惡性,且預測正確。
- 真負例 TN (右下 71):實際為良性,且預測正確。
- 假正例 FP (左下 1,誤報):實際為良性,但預測為惡性。
- 假負例 FN (右上 1,漏報):實際為惡性,但預測為良性。在醫療場景中,漏診通常帶來較大的風險。
該測試集準確率為 98.25%。
3. 決策閾值的權衡(Trade-off)
從混淆矩陣衍生出的常用指標:
- 精確率(Precision):預測為正類的樣本中,實際為正類的比例。
- 召回率(Recall):實際為正類的樣本中,被正確預測為正類的比例。
若要降低漏報率(FN),可考慮調整決策閾值。例如,將判斷為良性的標準提高(要求機率大於 才算良性)。這會降低漏報率,但可能增加誤報率。決策閾值的設定取決於實際應用場景對「誤報」與「漏報」的容忍度。
八、ROC 曲線與閾值選擇
為評估模型本身的分類能力,可使用 ROC 曲線與 AUC 分數。
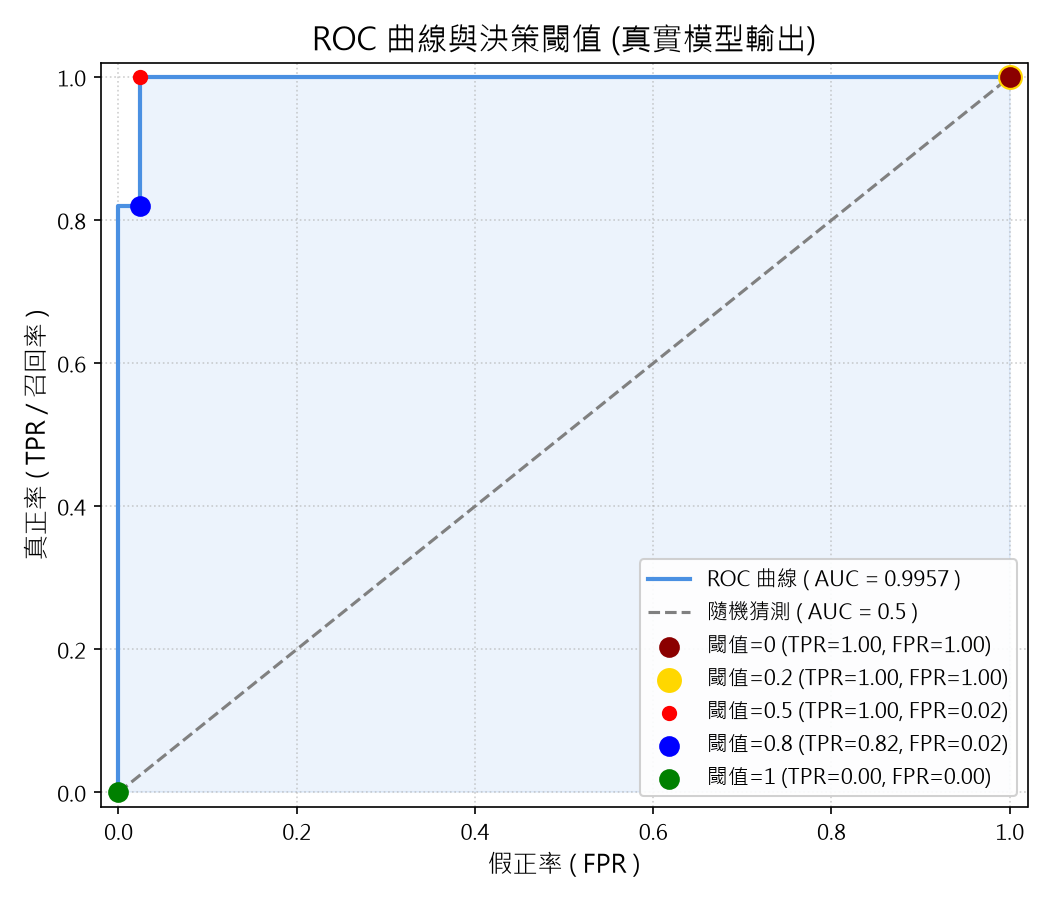
- ROC 曲線:繪製不同閾值下的假正率 (FPR) 與真正率 (TPR) 變化軌跡。曲線越靠近左上角,表示模型在較低 FPR 下能維持較高 TPR。
- AUC 分數 (0.9954):ROC 曲線下的面積,滿分為 。AUC 評估模型整體的排序能力,不受單一決策閾值影響。
閾值選擇範例
上圖中標示了五個不同閾值的點:
- 閾值 = 0(暗紅色):全部判為正類。TPR = 1.00,FPR = 1.00。缺乏鑑別力。
- 閾值 = 1(綠色):全部判為負類。TPR = 0.01,FPR = 0.00。漏診率高。
- 閾值 = 0.8(藍色):TPR = 0.81,FPR = 0.02。雖然 FPR 低,但在醫療場景中 19% 的漏報率偏高。
- 閾值 = 0.5(紅色)與 閾值 = 0.2(黃色):兩者 TPR 均為 1.00,FPR 均為 0.02。
選擇 0.5 或 0.2? 雖然在該測試集上表現相同,但在醫療等需要保守評估的場景中,常會選擇較低的閾值(如 0.2)作為緩衝,以降低潛在的漏報風險。實際選擇需視業務對 FPR 與 TPR 的權衡而定。
九、多分類:Softmax 迴歸
邏輯迴歸適用於二分類問題。對於多分類問題(例如:手寫數字辨識 0 到 9),通常使用 Softmax 迴歸。
1. Softmax 原理
- 為每個類別計算一個「得分」()。
- 透過 Softmax 函數,將得分轉化為機率分布。
- 各類別機率總和為 1。
公式:
直觀比喻: 在手寫數字辨識中,模型為 0 到 9 這 10 個類別各給出一個原始分數。Softmax 函數將這些分數透過指數運算 轉換為正數並放大差異,再計算每個類別的佔比。最終輸出即為機率分布,例如預測為「7」的機率是 85%,預測為「1」的機率是 14%,其餘 1%。
2. 深度學習的關聯
邏輯迴歸的結構與單層神經網路高度相似:
- 輸入層:特徵
- 權重與偏置:模型參數 與 。
- 激勵函數(Activation Function):Sigmoid(二分類)或 Softmax(多分類)。
- 輸出層結構:現代神經網路的輸出層,處理分類任務時經常採用 Softmax 結構。
十、總結:線性迴歸 vs 邏輯迴歸
兩者的差異對比表:
| 評估維度 | 線性迴歸 (Linear Regression) | 邏輯迴歸 (Logistic Regression) |
|---|---|---|
| 解決問題 | 回歸問題(預測連續數值) | 分類問題(預測類別) |
| 模型輸出 | 任意實數 | 介於 之間的機率 |
| 損失函數 | 均方誤差 (MSE) | 交叉熵 (Cross-Entropy) |
| 評估指標 | MSE / RMSE / | Accuracy / Precision / Recall / F1 / AUC |
核心觀念整理
- 結構關聯:邏輯迴歸可視為線性迴歸結合 Sigmoid 函數的結果。
- 指標選擇:分類任務應根據場景需求,綜合考量 Precision、Recall 及 F1 分數,而非僅看準確率。
- 實務應用:邏輯迴歸具備可解釋性佳、訓練速度快等特點,在工業界廣泛應用。
- 多分類延伸:透過 Softmax 迴歸擴展至多分類,是神經網路常見的基礎結構。